Tabellen verknüpfen mit JOIN
Lernziele
- Nach diesem Kapitel können Sie Tabellen über gemeinsame Spalten mit dem
JOIN-Befehl verknüpfen.- Sie können den Unterschied zwischen einem
INNER JOINund einemLEFT JOINverstehen und anwenden.- Sie können komplexe Abfragen über Verknüpfungstabellen aufbauen, um Daten aus n:m-Beziehungen auszulesen.
Im letzten Kapitel haben Sie gelernt, warum man Daten auf mehrere Tabellen aufteilt und wie Beziehungen zwischen Tabellen funktionieren. Jetzt wird es praktisch: Mit JOIN können Sie die normalisierten Tabellen wieder zusammenführen und Daten aus verschiedenen Tabellen in einer einzigen Abfrage kombinieren.
Erklärvideo
Ein überschaubares Beispiel: buildings und employees
Bevor wir zur Spotify-Datenbank zurückkehren, schauen wir uns die JOIN-Befehle an einem kleinen Beispiel an. Stellen Sie sich vor, wir hätten zwei Tabellen mit folgenden Daten, die wir anhand der Gebäudenamen zusammenführen möchten:
buildings
| building_name | capacity |
|---|---|
| 1e | 24 |
| 1w | 32 |
| 2e | 16 |
| 2w | 20 |
employees
| role | name | building | years_employed |
|---|---|---|---|
| Engineer | Becky A. | 1e | 4 |
| Engineer | Dan B. | 1e | 2 |
| Engineer | Sharon F. | 1e | 6 |
| Manager | Shirlee M. | 1e | 3 |
| Artist | Sherman D. | 2w | 8 |
| Manager | Daria O. | 2w | 6 |
| Artist | Jakob J. | 3e | 6 |
| Artist | Brandon J. | 3e | 7 |
Die JOIN-Arten
Mit SQL können Sie dem Datenbanksystem die mühselige Arbeit überlassen, diese Daten zusammenzuführen. Dazu gibt es mehrere JOIN-Varianten. Ein Tipp: Wenn Sie sich die Gebäudenamen in einem Venn-Diagramm (Mengendiagramm) vorstellen, sind die Befehle einfacher verständlich:
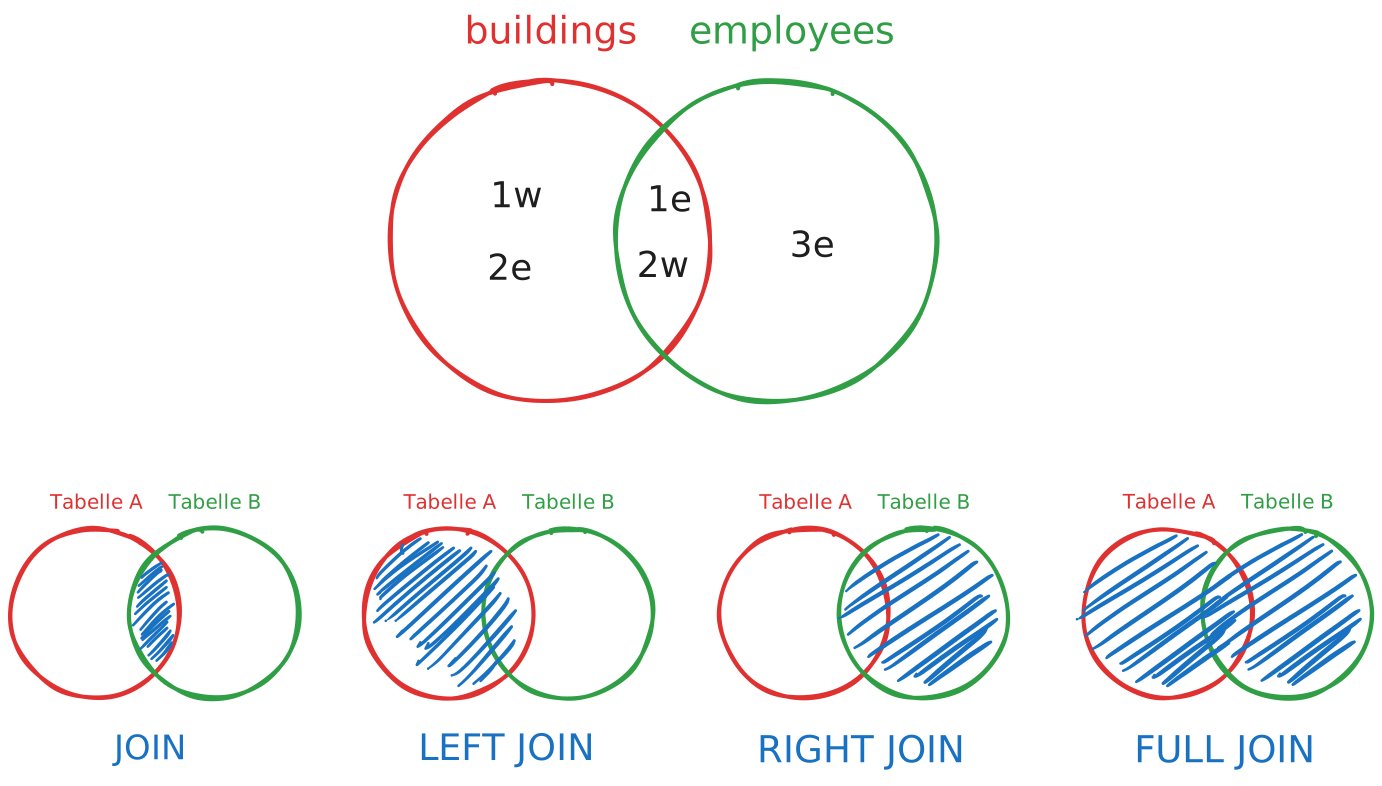
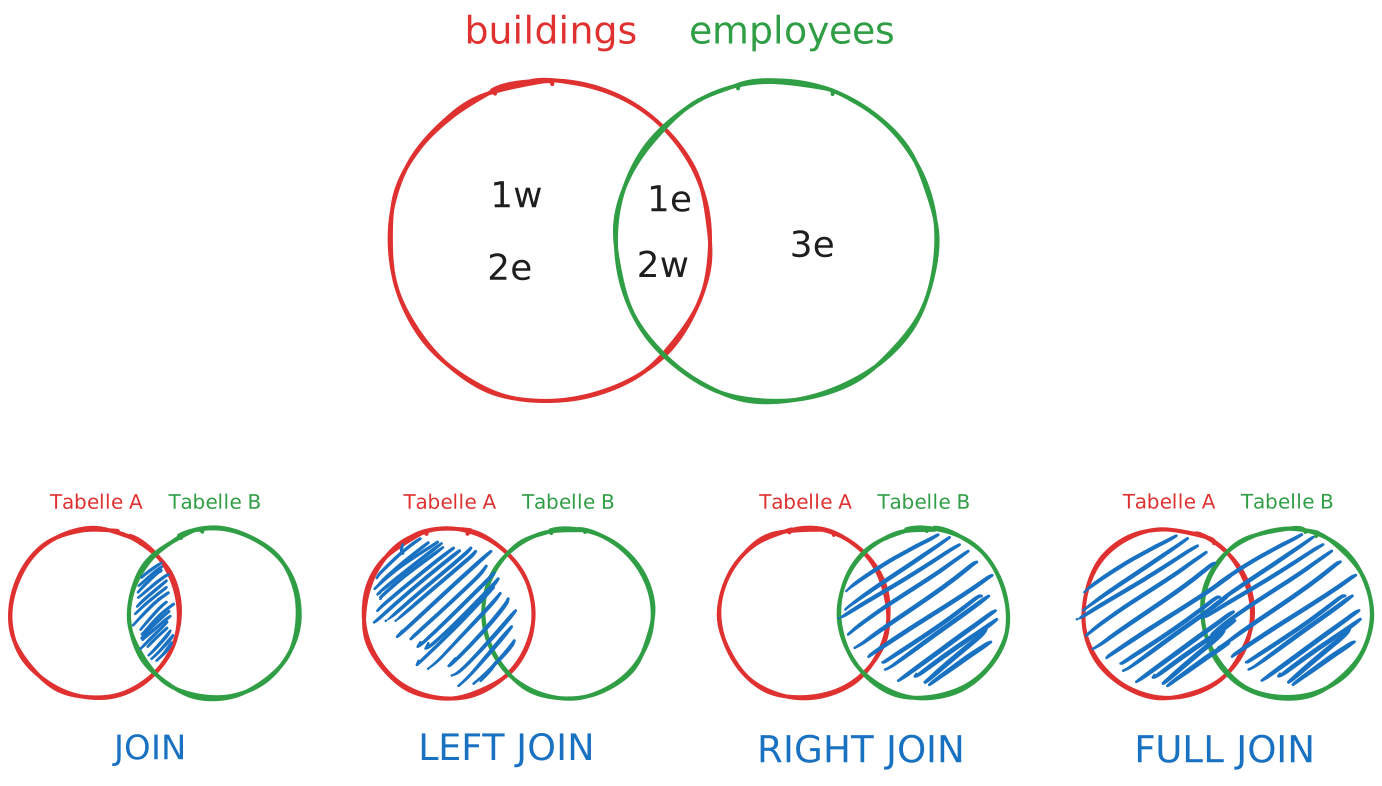
Schauen Sie sich die vier Varianten an — die Farben entsprechen dem Venn-Diagramm (rot = aus buildings, grün = aus employees). In allen vier Befehlen sagen Sie mit ON, welche Spalten zusammengehören: links vom = die Spalte der einen Tabelle (building_name aus buildings), rechts die der anderen (building aus employees). Achten Sie darauf, welche Zeilen jeweils erscheinen und wo NULL steht:
Gibt nur die Zeilen zurück, bei denen es in beiden Tabellen eine Übereinstimmung gibt. Gebäude ohne Mitarbeiter (1w, 2e) und Mitarbeiter ohne existierendes Gebäude (3e) fehlen im Ergebnis komplett!
SELECT *
FROM buildings
JOIN employees ON building_name = building;
| building_name | capacity | role | name | building | years_employed |
|---|---|---|---|---|---|
| 1e | 24 | Engineer | Becky A. | 1e | 4 |
| 1e | 24 | Engineer | Dan B. | 1e | 2 |
| 1e | 24 | Engineer | Sharon F. | 1e | 6 |
| 1e | 24 | Manager | Shirlee M. | 1e | 3 |
| 2w | 20 | Artist | Sherman D. | 2w | 8 |
| 2w | 20 | Manager | Daria O. | 2w | 6 |
JOIN und WHERE kombinieren
Das Ergebnis eines JOIN ist eine ganz normale Tabelle — Sie können sie also wie gewohnt mit WHERE filtern. Zwei Beispiele:
Aufgabe: Manager finden
Zeigen Sie name, building_name und capacity aller Mitarbeiter mit der Rolle Manager.
Aufgabe: Langjährige Mitarbeiter
Zeigen Sie name, years_employed, building_name und capacity aller Mitarbeiter, die seit mindestens 5 Jahren angestellt sind.
Aufgabe: Gebäude mit den meisten Engineers
In welchem Gebäude arbeiten am meisten Engineers? Zeigen Sie building_name und die Anzahl — nur das Gebäude mit den meisten. Kombinieren Sie dazu den JOIN mit den Aggregatsfunktionen aus dem letzten Kapitel.
Zurück zu Spotify
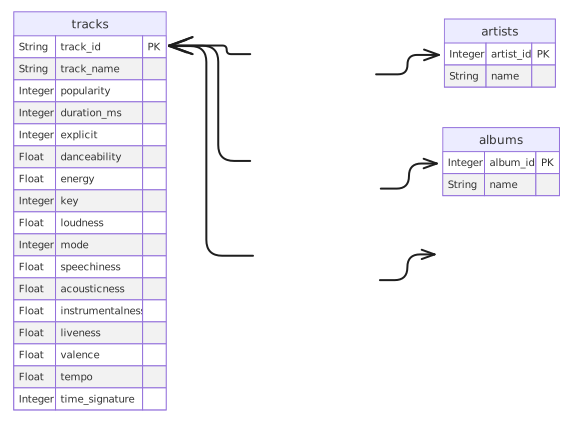
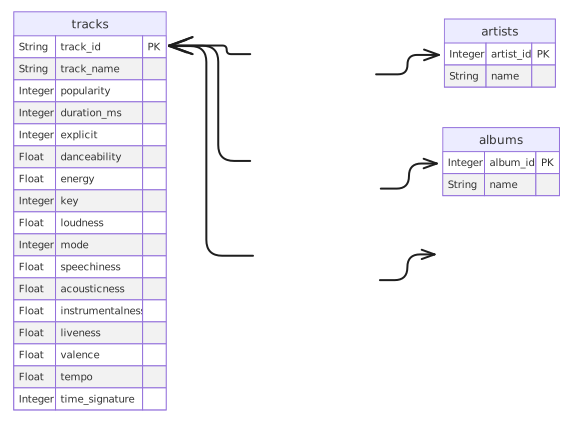
Ab jetzt arbeiten wir wieder mit der normalisierten Datenbank spotify.db statt der flachen spotify_flat.db. Zur Erinnerung das Schema:
Grundsyntax, Spaltennamen und Aliase
Bei buildings und employees konnten wir einfach building_name und building schreiben, weil jeder Spaltenname nur in einer der beiden Tabellen vorkommt. In der Spotify-Datenbank ist das anders: track_id gibt es in tracks und in track_artists, eine Spalte name sogar in artists, albums und genres. Damit klar ist, welche Spalte gemeint ist, schreibt man tabelle.spalte:
SELECT tabelle1.spalte, tabelle2.spalte
FROM tabelle1
JOIN tabelle2 ON tabelle1.gemeinsame_spalte = tabelle2.gemeinsame_spalte;
Weil ausgeschriebene Tabellennamen die Abfragen schnell lang machen, gibt man den Tabellen meist einen kurzen Alias: Direkt hinter dem Tabellennamen steht die Abkürzung — FROM tracks t bedeutet «die Tabelle tracks, im Folgenden kurz t»:
SELECT t.track_name, a.name
FROM tracks t
JOIN track_artists ta ON t.track_id = ta.track_id
JOIN artists a ON ta.artist_id = a.artist_id;
Hier steht t für tracks, ta für track_artists und a für artists. Alle folgenden Beispiele verwenden diese Schreibweise.
Beispiel: Songs mit Künstlernamen
Um Songs mit ihren Künstlern zu sehen, müssen wir über die Verknüpfungstabelle track_artists gehen:
Zwei JOINs nötigWeil Songs und Künstler über die Verknüpfungstabelle
track_artistsverbunden sind, brauchen wir zwei JOINs: erst vontrackszutrack_artists, dann vontrack_artistszuartists.
Beispiel: Songs mit Albumnamen
Auch die Album-Zuordnung läuft über eine Verknüpfungstabelle – ein Song kann auf mehreren Alben erscheinen:
Beispiel: Songs mit Genres
Dasselbe Prinzip gilt für Genres – auch hier brauchen wir eine Verknüpfungstabelle:
Beispiel: Kollaborationen sichtbar machen
Erinnern Sie sich an das Problem der flachen Tabelle, wo Ingrid Michaelson;ZAYN in einem einzigen Feld stand? In der normalisierten Datenbank sind beide Künstler einzeln gespeichert:
Beispiel: Alle Alben eines Songs
Da ein Song jetzt auf mehreren Alben erscheinen kann, können wir das mit einem JOIN sichtbar machen:
Beispiel: Songs, Künstler und Album zusammen
Sie können auch mehrere Tabellen in einer Abfrage verknüpfen:
JOIN mit Aggregatsfunktionen
JOINs lassen sich hervorragend mit den Aggregatsfunktionen aus dem letzten Kapitel kombinieren.
Welche Künstler haben die meisten Songs?
Songs mit den meisten Künstlern
In wie vielen Genres ist ein Künstler vertreten?
LEFT JOIN in der Praxis
Sie kennen den LEFT JOIN bereits vom buildings-Beispiel: alle Zeilen der linken Tabelle, auch ohne Treffer rechts. Genau das macht ihn zum Werkzeug, um «verwaiste» Einträge zu finden.
Beispiel: Gibt es Alben ohne Songs?
Mit einem LEFT JOIN können wir prüfen, ob es Alben in der Datenbank gibt, zu denen kein Song gespeichert ist:
NULL-Werte als IndikatorWenn
tab.track_id IS NULList, bedeutet das: Dieses Album existiert in deralbums-Tabelle, aber es gibt keinen Song intrack_albums, der darauf verweist. MitWHERE ... IS NULLnach einemLEFT JOINfindet man also «verwaiste» Einträge.
Unterschied zwischen JOIN und LEFT JOIN
RIGHT JOINEin
RIGHT JOINkommt in der Praxis selten vor, weil man die Abfrage meist einfach umdrehen und einenLEFT JOINverwenden kann.
Aufgaben
Aufgabe 1: Songs und Alben
Zeigen Sie die Spalten track_name und den Albumnamen für die 10 populärsten Songs. Sortieren Sie nach Popularität absteigend.
Aufgabe 2: Alle Künstler eines Songs
Zeigen Sie alle Künstler des Songs «Blinding Lights», inklusive ihrer Position. Sortieren Sie nach Position.
Aufgabe 3: Genres eines Songs
Finden Sie alle Genres, die dem Song «Tippa My Tongue» von den Red Hot Chili Peppers zugeordnet sind.
HinweisUm den Hauptkünstler einzuschränken, joinen Sie auch
track_artistsundartistsund filtern mitta.position = 1.
Aufgabe 4: Alben der Beatles
Finden Sie alle Alben von «The Beatles» und zählen Sie, wie viele Songs pro Album in der Datenbank sind. Sortieren Sie nach Anzahl Songs absteigend.
Aufgabe 5: Durchschnittliche Tanzbarkeit pro Künstler
Finden Sie die 10 Künstler mit der höchsten durchschnittlichen Tanzbarkeit, aber nur solche, die mindestens 20 Songs in der Datenbank haben. Zeigen Sie Künstlername, durchschnittliche Tanzbarkeit (gerundet auf 3 Stellen) und Anzahl Songs.
Aufgabe 6: Kollaborationen finden
Finden Sie alle Songs, an denen mehr als 5 Künstler beteiligt sind. Zeigen Sie den Songtitel und die Anzahl der Künstler, sortiert nach Anzahl absteigend. Begrenzen Sie auf 15 Ergebnisse.
Aufgabe 7: Komplett-Abfrage
Erstellen Sie eine vollständige Übersicht: Zeigen Sie für die 10 populärsten Songs den Titel, den Hauptkünstler (Position 1), ein Album, das Genre, die Popularität und die Tanzbarkeit. Sortieren Sie nach Popularität absteigend.
HinweisDa ein Song mehrere Alben und Genres haben kann, erscheint er möglicherweise mehrfach im Ergebnis. Um nur eine Zeile pro Song zu bekommen, können Sie mit
GROUP BY t.track_idgruppieren undMIN(al.name)bzw.MIN(g.name)verwenden.
Zusammenfassung
Was Sie gelernt haben
- Mit JOIN verknüpfen Sie Tabellen über gemeinsame Spalten
- Ein JOIN (= INNER JOIN) zeigt nur Zeilen mit Übereinstimmung in beiden Tabellen
- Ein LEFT JOIN zeigt alle Zeilen der linken Tabelle, auch ohne Treffer rechts
- Ein RIGHT JOIN zeigt alle Zeilen der rechten Tabelle (wird selten verwendet)
- Ein FULL JOIN zeigt alle Zeilen beider Tabellen
- Verknüpfungstabellen lösen Viele-zu-Viele-Beziehungen (Songs ↔ Künstler, Songs ↔ Alben, Songs ↔ Genres)
- Sie können mehrere JOINs in einer Abfrage kombinieren
- JOINs lassen sich mit WHERE, GROUP BY, HAVING und ORDER BY kombinieren
- Eine normalisierte Datenbank vermeidet Duplikate und Inkonsistenzen der flachen Tabelle